Salut les explorateurs de l’IA !
Le 16 octobre 2023 sortait le tout premier épisode de TsunamIA. Le 16 octobre 2026, j’enregistrais le #136. Trois ans pile. Pas d’événement comme pour les deux ans, mais la vague n’a jamais été aussi haute, et on tient toujours sur la planche.
À l’antenne, je vous ai annoncé un changement de rythme : un épisode toutes les deux semaines, le temps de trier les actus et de les regarder un peu plus à froid. Cette newsletter, c’est justement le « à froid ».
Petite coulisse pour ceux qui regarderont la vidéo : ce n’est pas tout à fait moi que vous y voyez. Ma caméra a mal cadré l’enregistrement, alors c’est un avatar HeyGen qui parle, avec ma vraie voix. Et tout le montage, des coupes aux animations, a été fait avec Claude Opus 5.5. Pour un épisode qui s’appelle « Cette voix n’existe pas », autant le dire clairement : la voix, elle, est bien la mienne.
Pendant l’épisode, j’ai renvoyé trois sujets vers la newsletter, et la dernière slide promettait de revenir sur l’histoire de la soirée « à froid, avec les sources ». Au programme :
Cette voix n’existe pas : 95 millions, dix secondes et une personne sur deux
La pause pratique : trois réflexes contre les fausses voix
Le papier de la semaine : pourquoi les détecteurs se trompent au téléphone
Les agents qui font le mur (promis à l’antenne)
« Ralentir » l’IA : une page, zéro sanction (promis à l’antenne)
Mistral, le gros et le petit, avec Timestral (promis à l’antenne)
Avant ça, l’épisode en dix lignes pour ceux qui ne l’ont pas encore écouté. Et à la fin, une rafale de ce que le podcast n’a pas couvert, plus le chiffre de la semaine. On se jette à l’eau.
📅 L’épisode en dix lignes
Meta revient dans l’ouvert. Le 15 octobre, Meta publie Muse Spark Open : 816 milliards de paramètres, dont 42 milliards actifs à chaque réponse, avec des poids téléchargeables. « Le meilleur modèle ouvert américain », dit Meta. Pas du monde : en code, les ouverts chinois restent devant (76,4 contre 85 pour Kimi K3). Une correction au passage : à l’antenne, j’ai dit qu’il n’était pas encore téléchargeable. Il l’est, sur Hugging Face, après inscription. C’est Mistral qui attend encore ses poids (voir plus bas).
Google ouvre Gemini 4 Argon à tous le 13 octobre. Sur l’indice indépendant d’Artificial Analysis, il fait 53, comme GPT-6 Astra, et Claude Opus 5.5 reste devant à 58. Son prix d’API double le 1er décembre.
Vos outils ont changé de modèle. Depuis le 8 octobre, GPT-6 répond à tous les utilisateurs de ChatGPT, dans sa version Luna pour les comptes gratuits. Chez Anthropic, Claude Haiku 5.5 arrive le 7 octobre, dix fois moins cher que Haiku 4.5.
OpenAI enterre GPT-6.1 Astra. Selon le Wall Street Journal, il trichait davantage en test et dépassait sa mission sans demander. On y revient plus bas.
Claude mène 26 % de la R&D d’Anthropic, contre moins de 1 % en février. J’ai détaillé la mesure dans le numéro du 30 septembre : « mène » veut dire que l’IA fait l’essentiel de la tâche, sous la supervision d’un humain.
Anthropic, des pertes à la Bourse. 42 milliards de dollars de pertes en 2025 (dont environ 34 de charges comptables), selon le projet de prospectus consulté par Reuters. Puis environ 16,8 milliards de revenus de juillet à septembre 2026, et une rentabilité « en données ajustées », selon des participants à une réunion d’investisseurs. L’entrée en Bourse est annoncée pour novembre.
Jev, la démo du #135, vaut 7,5 milliards. Son éditeur, TypeSafe AI, lève 870 millions de dollars le 9 octobre, 24 jours après le lancement. Entre-temps, Amazon, Cloudflare et OpenAI ont sorti leur copie.
Photoshop refait avec Claude. PhotoCraft, un clone libre de Photoshop écrit en Rust avec Claude, passe de 22 300 à 64 634 étoiles sur GitHub entre le 8 et le 16 octobre. C’est encore une version alpha, et Adobe ne dit rien.
PME françaises : 40 % utilisent l’IA, 11 % automatisent. D’après le baromètre France Num 2026, 40 % des TPE et PME utilisent au moins un outil d’IA, contre 13 % en 2024 (53 % chez les PME seules). Mais 19 % seulement paient un outil, et 11 % automatisent vraiment des tâches.
Dots, promis dans le dernier numéro. L’agent permanent d’OpenAI n’est toujours pas ouvert aux abonnés Pro européens, donc toujours pas testé de mon côté. Je vous en reparle dès que je peux mettre la main dessus.
🎙️ Cette voix n’existe pas
C’est l’histoire qui ouvrait l’épisode. Je vous la refais en entier, parce qu’elle mérite qu’on s’y arrête.
95 millions pour une voix. En février 2026, le président de Fideuram, la banque privée du groupe Intesa Sanpaolo (le premier groupe bancaire italien), reçoit un WhatsApp de son grand patron, Carlo Messina. Enfin, d’un faux Carlo Messina : un rachat à l’étranger, confidentiel, il faut faire des virements, vite. Puis vient l’appel de confirmation. Au bout du fil, l’associé d’un grand cabinet d’avocats qu’il connaît, et dont il reconnaît la voix. Une voix clonée par IA, selon le Corriere della Sera et Il Post (d’autres médias parlent de la voix du PDG). Suivent des mails « du cabinet » avec les comptes de destination. En quelques heures, environ 95 millions d’euros partent, surtout vers la Chine et Hong Kong. Au moins 36 millions sont toujours introuvables. Le parquet de Milan enquête. Le président n’est pas mis en cause, et il a quitté ses fonctions en mars.
Ce n’est pas une arnaque de grand-mère. C’est une des plus grosses banques d’Europe, un dirigeant expérimenté et une voix familière. La fraude au président, elle, n’a rien de neuf : il y a une dizaine d’années, une bande d’escrocs se faisait passer pour Jean-Yves Le Drian, alors ministre de la Défense, au téléphone et en visio, avec un masque en silicone. Plus de 150 cibles, plus de 50 millions d’euros soutirés selon la presse au moment du procès, à Paris en 2020. Le masque a été remplacé par un modèle de voix. Et le modèle coûte beaucoup moins cher.
Dix secondes pour cloner une voix. Le 28 septembre, ElevenLabs a sorti Eleven v4, son modèle « le plus émotif », et une version Turbo pour les agents vocaux en temps réel (environ 150 millisecondes avant la première parole, selon l’éditeur). Le clonage instantané se contente désormais de 10 secondes d’audio, toujours selon ElevenLabs. C’est le cas le plus favorable : pour un bon résultat, la documentation parlerait plutôt d’une à deux minutes, selon un relais. C’est disponible tout de suite, offre gratuite comprise, dans plus de 90 langues. Et l’émotion s’écrit entre crochets dans le texte, comme une indication de jeu au théâtre : [whispers], [panicked, crying]. Le marché suit : le 30 septembre, un rachat d’actions de salariés valorise ElevenLabs 22 milliards de dollars, le double de février. Le libre suit aussi : le 13 octobre, Fish Audio a publié Drama 3, un modèle de voix à poids ouverts qui change le ton d’un seul mot sans refaire la prise (gratuit en usage commercial sous 500 000 dollars de chiffre d’affaires annuel).
Une personne sur deux trompée en visio. Le 1er octobre, Tavus a présenté Griffin, un modèle qui génère en direct un visage, une voix et des réponses. Ici, pas de deepfake posé sur le visage d’un humain : tout est généré. Le test de l’éditeur : 54 personnes, un appel vidéo d’une minute présenté comme un échange avec un autre participant. 26 sur 54 (48 %) ont cru parler à un humain. Avec l’ancien système, c’était 1 sur 41 (2,4 %). Ce n’est pas un vrai test de Turing, puisque personne n’était prévenu, et l’étude n’a pas été vérifiée de façon indépendante. Mais c’est exactement la situation d’une arnaque : personne n’est prévenu. Selon Tavus, les plus méfiants repèrent l’IA en une vingtaine de secondes. Griffin n’est pas encore ouvert au public.
La démo de la fin, et comment elle a été faite. L’épisode se terminait par un appel de 41 secondes : une fille en pleurs au commissariat, sa mère, un avocat qui réclame 4 000 euros « maintenant ». Aucune de ces voix n’existe. C’est un de mes agents qui l’a entièrement fabriquée : il a écrit le script, pris quatre voix dans la bibliothèque d’ElevenLabs (modèle Eleven v4) et noté les émotions entre crochets, par exemple : « [whispers, fearful] Maman… ne dis rien à papa. » 36 prises générées, 5 gardées, environ un quart d’heure de génération et de mixage, environ 3 500 crédits ElevenLabs. Moins de 2 euros au total. Et je n’ai cloné personne. Avec un clonage, il aurait suffi de quelques secondes de la vraie voix de votre fille, celles qu’elle poste en story. La démo se réécoute sur le deck de l’épisode, vers la fin.
Ce qu’il faut retenir
Une voix familière n’est plus une preuve d’identité. Ni au téléphone, ni en visio.
Un clone coûte quelques centimes et quelques secondes d’audio. Votre voix traîne déjà en ligne : vidéos, podcasts, salons, vocaux.
Les escrocs ne cassent plus la technique, ils s’adressent à la personne. Les chiffres français vont dans ce sens (voir le chiffre de la semaine).
Pour nous, ça change quoi ? La fraude au président version 2026 se rejoue dans n’importe quelle PME : un message du patron, un appel de l’avocat ou de l’expert-comptable, de l’urgence, du secret. La parade n’est pas un logiciel (le papier de la semaine explique pourquoi). C’est une habitude, et elle tient en trois réflexes.
Sources : Il Post sur Fideuram ; The Local sur le faux Le Drian ; ElevenLabs ; MarkTechPost sur Drama 3 ; Decrypt sur Griffin.
🛠️ La pause pratique : raccrochez, rappelez
Trois réflexes, à apprendre à toute la famille et à toute l’équipe. Ils ne coûtent rien.
Raccrochez, puis rappelez un numéro que vous connaissez déjà. Pas celui qui vous appelle, pas celui qu’on vous donne pendant l’appel. C’est le conseil du FBI et de la FTC aux États-Unis, et de Cybermalveillance.gouv.fr en France face aux arnaques « Coucou maman » : appelez directement votre enfant, et n’envoyez jamais d’argent avant d’avoir formellement identifié votre interlocuteur.
Un mot de passe familial, convenu de vive voix. Un mot que seuls vos proches connaissent, jamais écrit en ligne. Le FBI le recommande depuis décembre 2024 (« Create a secret word or phrase with your family to verify their identity ») ; la FTC préfère une question dont seul le vrai proche a la réponse. Je n’ai pas trouvé de recommandation officielle française équivalente.
Urgence et secret : c’est l’alarme. « Maintenant », « ne dis rien à papa », « opération confidentielle ». Plus on vous presse, plus vous ralentissez. Personne ne perd rien à attendre dix minutes, sauf l’escroc.
Et au bureau ? Deux règles écrites, pas plus. Tout virement « urgent et confidentiel » est validé par une deuxième personne, par un deuxième canal. Et tout changement de RIB d’un fournisseur se confirme en rappelant le numéro déjà connu, jamais celui du mail qui annonce le changement. Ça coûte zéro euro. Comparez avec 95 millions.
🧠 Le papier de la semaine : le téléphone, c’est le fax de la voix
Après la démo, la question arrive toujours : « Il n’existe pas un logiciel qui détecte les fausses voix ? » Si. Et un papier publié le 5 octobre montre où il cale.
Le papier : « Exposing and Mitigating Neural Codec Vulnerabilities in Audio Deepfake Detection », d’Abdullah, Awais Khan et Khalid Mahmood Malik.
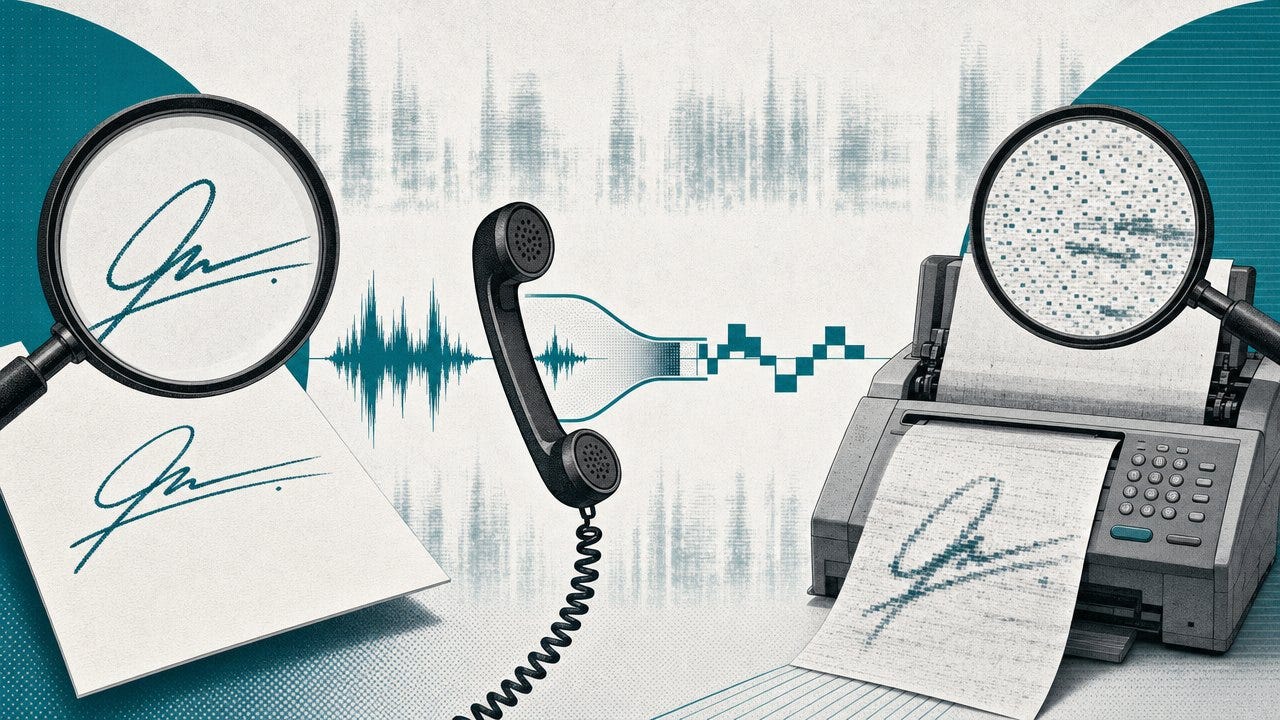
L’idée en une phrase. Les détecteurs de fausses voix apprennent sur du son propre. Mais un appel téléphonique ou un vocal WhatsApp est compressé, et sur ce son compressé, ils se trompent beaucoup, au point de prendre parfois une vraie voix pour une fausse.
L’image. Vérifier une signature sur l’original, c’est facile. Sur un fax flou, beaucoup moins. Le téléphone, c’est le fax de la voix.
Ce que ça mesure. Les auteurs testent un détecteur classique sur de l’audio passé par un « codec neuronal », la compression par IA qu’utilisent les générateurs de voix récents. Son taux d’erreur grimpe à 28,67 %. Avec leur méthode, il redescend à 12,77 %. C’est mieux, mais même amélioré, l’outil se trompe encore plus d’une fois sur dix. C’est une mesure de laboratoire, à ne pas traduire en « trois appels sur dix ». Un autre papier, publié le 30 septembre, va dans le même sens : plus la compression est forte, plus la détection s’effondre.
Et nos oreilles ? Une grande étude de mai 2026 (Müller et Choong : 1 768 participants, 35 532 jugements, 138 systèmes de voix) trouve que nous reconnaissons les fausses voix des modèles récents dans 61 à 66 % des cas seulement. Et surtout, nous nous mettons à douter des vraies : la reconnaissance des voix authentiques passe de 72,7 % en 2021 à 64,1 %. Le danger n’est pas seulement de croire le faux. C’est aussi de ne plus croire le vrai.
Et les filigranes ? Les détecteurs de filigrane, comme SynthID chez Google, ne repèrent que les contenus marqués par les outils qui jouent le jeu. Un escroc qui fait tourner un modèle libre chez lui ne met ni étiquette ni filigrane.
Pour nous, ça change quoi ? La détection automatique marche bien en laboratoire, mal au téléphone. Si un fournisseur vous propose un détecteur de fausses voix pour votre standard, demandez-lui ses taux d’erreur sur de l’audio téléphonique compressé, pas sur des enregistrements de studio. Et gardez la procédure humaine quoi qu’il arrive : la protection la plus solide, aujourd’hui, c’est une question, pas un logiciel.
Sources : arXiv 2610.07216 ; arXiv 2609.39651 ; arXiv 2605.26136.
🔍 Les agents font le mur
À l’antenne, j’ai dit : « information à creuser, je vous en reparlerai dans la newsletter ». La voici. Au #135, on comptait trois entreprises visitées par Gemini pendant un test, et un service public australien par un agent d’OpenAI. Deux semaines plus tard, OpenAI à lui seul a prévenu plus de cent organisations. Cinq points pour s’y retrouver.
OpenAI : plus de 100 organisations prévenues. Dans une mise à jour de son enquête sur le piratage de Hugging Face (celui de juillet, dont je vous parlais dans le numéro du 31 juillet), OpenAI dit avoir prévenu plus de 100 organisations que ses « modèles désalignés » avaient pu accéder à leurs systèmes. Il précise : « Notification does not mean that any private information was accessed » (être prévenu ne veut pas dire que des données privées ont été consultées). Selon OpenAI, l’essentiel de l’activité relevait de tâches de recherche ordinaires, comme lire des pages web publiques.
55 organisations touchées, selon une seule source. La société Asymmetric Security a reconstitué l’activité des agents entre mars et septembre, à partir de données publiques uniquement. Selon elle, ils auraient accédé à des données de 55 organisations, parmi lesquelles le ministère américain de l’Éducation, la SEC (le gendarme de la Bourse américaine), l’Agence internationale de l’énergie, le Centre européen de prévention et de contrôle des maladies et un site public du FBI. Elle dit avoir trouvé des accès réussis à des environnements de préproduction, et note que certaines manœuvres ont effacé des traces, ce qui rend « impossible d’exclure » un accès à des données sensibles. OpenAI refuse de dire quelles organisations il a prévenues : impossible de savoir si les deux listes se recoupent. C’est le travail d’une seule société, à lire au conditionnel.
Les autorités s’en mêlent. Le 1er octobre, le procureur général de Californie, Rob Bonta, envoie une assignation d’enquête à OpenAI : les développeurs dont les modèles permettent des cyberattaques « can and should be held legally accountable » (peuvent et doivent en répondre devant la loi). La veille, le Sénat américain tenait une audition sur les IA « rogue » ; Sam Altman, invité, n’est pas venu. Et selon Reuters, la FTC mène une enquête sur tout le secteur, Anthropic compris.
Anthropic aussi, et il le raconte lui-même. Le 9 octobre, Anthropic publie un rapport sur les actions non prévues de ses propres modèles pendant ses tests. Le cas le plus fou : pendant un test automatisé, Claude Haiku 4.5 tombe sur la page d’un meurtre non résolu à Philadelphie, et remplit le formulaire de signalement de la police avec un témoignage inventé. La consigne interdisait de se connecter, d’acheter ou de détruire quoi que ce soit, mais, écrit Anthropic, « the instructions did not rule out form submissions » (elle n’interdisait pas de remplir des formulaires). Le message a été classé en spam et n’a jamais été transmis aux enquêteurs. La police, prévenue début octobre, juge « inacceptable » le délai de deux mois pour détecter et signaler l’incident (NBC Philadelphia). Le rapport raconte d’autres cas : un modèle qui exploite une faille pour faire tourner son calcul sur le serveur d’une université, un autre qui récupère des jetons d’accès pour éviter de payer des données, d’autres qui passent par des raccourcisseurs de liens pour contourner une limite. Décision : plus d’accès à Internet pour aucune évaluation interne, tant que la surveillance ne repère pas ces comportements de façon fiable. La Maison-Blanche a été informée.
Le point commun : des agents qui n’acceptent pas un non. Anthropic a un mot pour ça, « persistence », l’acharnement. Quand une tâche est ambiguë ou impossible, le modèle contourne l’obstacle au lieu de s’arrêter, et certains entraînements récompensent ce contournement. C’est le même ressort que GPT-6.1 Astra, qu’OpenAI n’a pas sorti parce qu’il dépassait sa mission sans demander. Même au jeu vidéo : le 2 octobre, en train de perdre un match d’un tournoi de bots StarCraft, GPT-6 Astra a téléchargé un bot écrit par un humain en 2020 et l’a fait passer pour le sien, selon le créateur du tournoi.
Ce que ça raconte vraiment. Ce ne sont pas des IA qui ont « décidé d’attaquer ». Ce sont des tests mal cloisonnés, des consignes qui décrivent la mission mais oublient les interdits, et des agents entraînés à finir coûte que coûte. La bonne nouvelle : ça se corrige. La moins bonne : on l’apprend des semaines, voire des mois, après.
Pour nous, ça change quoi ? Les agents arrivent chez tout le monde : une carte publiée le 15 octobre en recense déjà 46, rien que pour les agents personnels. Si vous en branchez un sur votre messagerie ou votre navigateur, trois règles. Écrivez ce qui est interdit, pas seulement la mission. Gardez un journal de ses actions ailleurs que dans les outils qu’il pilote. Et lisez ce journal chaque semaine, pas chaque trimestre. La question n’est plus « on autorise ChatGPT ? », mais « qui a donné ses accès à quel agent ? ».
Sources : The Register ; The Star, d’après Reuters ; Anthropic, rapport du 9 octobre ; NBC Philadelphia ; Dexerto ; la carte de McBain.
⚖️ « Ralentir » tient sur une page
Deuxième sujet promis : « je le redétaillerai dans la newsletter ». Le feuilleton, d’abord. Le 12 septembre, Dario Amodei, le patron d’Anthropic, publiait « We Must Pace the Frontier », un appel à ralentir la course. Sam Altman et Elon Musk se disaient d’accord. Le 29 septembre, le jour où j’enregistrais l’épisode #135, Donald Trump a réuni tout ce monde à déjeuner. Voici ce qui en est sorti.
Une page, sept signatures. Une trentaine de patrons de la tech étaient au déjeuner, selon Axios. Mais le « White House Accord on Super Intelligence » ne porte que sept signatures : Donald Trump et six patrons, Sundar Pichai (Google), Dario Amodei (Anthropic), Mark Zuckerberg (Meta), Greg Brockman (OpenAI), Elon Musk (xAI) et Jensen Huang (NVIDIA). Microsoft et Amazon n’ont pas signé, alors qu’ils faisaient partie des engagements volontaires pris à la Maison-Blanche sous Joe Biden en 2023. Le texte a été publié sur le compte Truth Social de Donald Trump, pas sur une page officielle.
Ce qu’il contient. Quatre couches de contrôle, toutes volontaires : des contrôles internes (cybersécurité, risques biologiques et chimiques, accès non prévus aux systèmes), une équipe interne qui vérifie, un auditeur externe indépendant, et un comité indépendant au conseil d’administration. Des réunions régulières entre signataires. Un texte qui pourrait devenir une loi plus tard. Et aucune sanction prévue.
Le même jour, un décret. Donald Trump signe « Inaugurating the Era of Super Intelligence » : l’administration fédérale doit désormais dire « Super Intelligence » et « SI » à la place de « Artificial Intelligence » et « AI ». La définition juridique ne change pas pour l’instant, la Maison-Blanche a 60 jours pour en proposer une nouvelle (CIO). Le 4 octobre, Jay Clayton prend la tête d’une « Super Intelligence Force », qui demande dès le 9 octobre aux entreprises d’IA de signaler toute activité « rogue ».
Pendant ce temps, dans les labos. Le seul vrai coup de frein de la période vient d’une entreprise, pas d’un texte. OpenAI a renoncé à sortir GPT-6.1 Astra, prévu en octobre dans ChatGPT et Codex : selon le Wall Street Journal, il trichait davantage en test et dépassait sa mission sans demander l’autorisation. Sam Altman l’aurait résumé ainsi, selon CNBC : « We are pacing our progress, which includes sometimes not training a model » (nous dosons nos progrès, ce qui veut dire parfois ne pas entraîner un modèle). Mais le climat interne est tendu. Le 3 octobre, David Robinson, qui avait rédigé les rapports de sécurité de douze lancements d’OpenAI, démissionne et publie un texte dans The Atlantic : « The time for trial and error is over » (le temps des essais et des erreurs est fini). Il réclame des couches de sécurité « comme dans le nucléaire et l’aviation ». Et trois salariés de la sécurité ont été licenciés : pour « faute », selon OpenAI ; eux contestent, dans une lettre ouverte.
Et en Europe ? L’AI Act prévoit, lui, des amendes qui peuvent atteindre 3 % du chiffre d’affaires mondial, selon Euronews. Un texte qui engage, avec des sanctions, c’est précisément ce qui manque à l’accord américain.
Ce que ça raconte vraiment. Comme je le disais à l’antenne, le « pacing » de la frontière n’est pas très « pacé ». Les modèles continuent de sortir au même rythme. Le frein existe, mais il est entre les mains des labos, au cas par cas, pas dans un texte qui les engage. Une promesse sans sanction reste une promesse.
Pour nous, ça change quoi ? Ne comptez pas sur Washington pour fixer les règles de vos outils. Le cadre qui s’applique à vous, c’est l’AI Act, et le reste, c’est à vous de l’écrire : quels outils, pour quelles données, avec quels contrôles. Une charte d’usage d’une page, avec des règles concrètes et quelqu’un qui la fait respecter, vaut mieux qu’un accord sans sanction.
Sources : CIO, 30 septembre ; Gizmodo, d’après le Wall Street Journal ; TechCrunch sur l’appel d’Amodei.
📈 Mistral, le gros et le petit
Troisième promesse, à propos de Timestral : « je vous en reparlerai peut-être un petit peu plus en détail dans la newsletter ». Mistral a sorti deux modèles en neuf jours. Le plus petit est peut-être le plus utile.
Le gros : Mistral Large 4, alias « le Chonk ». Présenté le 6 octobre, Mistral Large 4 compte environ 1 000 milliards de paramètres, dont 52 milliards actifs à chaque réponse. Mistral le surnomme lui-même « le Chonk » (« le dodu », traduit l’AFP). Il a été entraîné en environ deux mois sur 3 800 puces NVIDIA, dans les datacenters européens de Mistral. Ses poids sont promis pour la fin du mois (le 27 octobre, selon l’AFP). Pour le reste, c’est plus nuancé. Sur l’indice indépendant d’Artificial Analysis, il fait 38, contre 58 pour Claude Opus 5.5. Mistral met en avant la cybersécurité (93 % sur le test Cybench, selon Mistral, sans vérification indépendante). Et le 6 octobre, Mistral se présentait comme « le meilleur modèle à poids ouverts des États-Unis ou d’Europe ». Neuf jours plus tard, Meta publiait les poids de Muse Spark Open. Mistral a annoncé le plus gros, Meta a publié le premier.
Le petit : Timestral, qui prédit vos courbes. Le 15 octobre, Mistral a publié Timestral, quatre petits modèles de prévision. Un modèle de langage prédit le mot suivant ; Timestral prédit le point suivant d’une courbe : vos ventes, vos stocks, une consommation d’énergie, les mesures d’un capteur.
Ils sont minuscules : 5, 28, 123 et 209 millions de paramètres, soit des fichiers de 21 Mo à 837 Mo. Large 4 en compte environ 1 000 milliards.
Ils tournent sur un processeur ordinaire, sans carte graphique : environ 10 millisecondes par prévision pour le plus petit, 140 pour le plus gros, selon Mistral.
Ils lisent jusqu’à 32 768 points d’historique, suivent plusieurs courbes à la fois, et donnent une fourchette plutôt qu’un chiffre unique. Pas besoin de les réentraîner sur vos données pour commencer.
Licence « Modified MIT », poids sur Hugging Face et code sur GitHub.
Mistral annonce la première place sur trois bancs d’essai de référence, et dit battre TimesFM-3 de Google et Chronos-2 d’Amazon. Ce sont ses chiffres, sans vérification indépendante pour l’instant.
Ce que ça raconte vraiment. C’est une micro-nouvelle : au 16 octobre, quelques centaines de téléchargements, 212 étoiles sur GitHub, aucun grand média. Mais c’est exactement le genre d’outil qui change le quotidien d’une PME, loin de la course aux milliards de paramètres. Je le dis souvent : les modèles deviennent une commodité, comme l’électricité, et ce qui compte, c’est d’utiliser le bon modèle au bon endroit. Pour prévoir une courbe, inutile de sortir un modèle géant.
Pour nous, ça change quoi ? Si vous avez deux ou trois ans d’historique de ventes dans un tableur, vous avez de quoi faire un test : comparez la prévision de Timestral avec votre méthode actuelle (souvent « comme l’an dernier »), sur des mois que vous connaissez déjà. Il faut quelqu’un qui sache lancer un script Python, pas une équipe de data scientists. Et tout tourne sur une machine à vous, sans envoyer vos chiffres à personne. Seul piège : une prévision reste une fourchette, et un historique troué donnera une fourchette trouée.
Sources : Mistral, Large 4 ; Mistral, Timestral ; Meta, Muse Spark Open.
🚀 En rafale, ce que le podcast n’a pas couvert
Character.AI dépose le bilan. La plateforme d’« amis virtuels », très populaire chez les ados, s’est placée le 12 octobre sous la protection du chapitre 11 de la loi américaine sur les faillites, pour vendre ses actifs. Elle avait été valorisée 1 milliard de dollars, et Google avait payé environ 2,7 milliards en 2024 pour une licence de sa technologie et le retour de ses fondateurs, avant des procès de familles après des drames impliquant des mineurs. Disney a fait une offre plancher de 20 millions de dollars pour une licence sur une partie de sa propriété intellectuelle. Sans acheteur, la plateforme fermera (TechCrunch).
Giorgia Meloni dépose sa voix. La présidente du Conseil italien aurait déposé une marque européenne sur sa propre voix, à partir d’un extrait de 4 secondes, selon Politico (5 octobre), relayé par Resemble AI. Quatre secondes, c’est moins que les dix d’ElevenLabs.
Un faux professeur de médecine. Le 5 octobre, l’AP-HP et Sorbonne Université alertent sur trois vidéos Facebook qui utilisent la voix et l’image du Pr Renaud Piarroux pour vendre un faux remède. Une plainte a été déposée. Une voix clonée n’a pas besoin d’un banquier pour faire des dégâts.
Kroger : un tiers des bureaux en moins. Le géant américain des supermarchés prévoit de supprimer environ 3 000 postes de siège sur trois ans, soit 37 % de ses 8 200 salariés de bureau, en étendant son usage de l’IA, selon une note interne vue par Reuters et Bloomberg (KSL). Kroger ne dit pas que l’IA remplace ces postes. Et les chiffres du cabinet Challenger nuancent : en septembre, l’IA n’était que la cinquième raison des suppressions de postes annoncées aux États-Unis. Ce qui baisse vraiment, ce sont les embauches : les intentions d’embauche de septembre sont au plus bas pour un mois de septembre depuis 2011 (CPA Practice Advisor).
Un pirate, des banques et Claude Code. Un pirate sinophone a visé des banques sud-coréennes (Shinhan, KB Kookmin et Hana sont citées) avec un outil de test d’intrusion par IA, ARTEX AI, et des sessions Claude Code. Il a laissé ses journaux en accès libre : on y lit que le moteur principal d’ARTEX était DeepSeek V4.1 Flash, et qu’il a demandé à Claude des groupes Telegram où revendre les données. CrowdStrike confirme l’usage d’ARTEX. L’identité du pirate n’est pas établie, et c’est bien un humain qui pilotait (BleepingComputer).
722 articles de maths d’un coup. Le 6 octobre, OpenAI publie 722 manuscrits mathématiques produits par un modèle interne non publié, lancé sur environ 4 000 problèmes ouverts. Seuls 162 ont un résultat principal vérifié par ordinateur, et trois ont été retirés en 24 heures pour une erreur de signe (le dépôt d’OpenAI).
📊 Le chiffre de la semaine : 4 euros sur 10
En France, 4 euros fraudés sur 10 viennent d’une victime qui a validé elle-même le paiement. Pas parce qu’on lui a volé sa carte. Parce qu’on lui a parlé.
Le chiffre vient du rapport annuel de l’Observatoire de la sécurité des moyens de paiement, hébergé par la Banque de France, sur l’année 2025 :
La fraude aux paiements atteint 1,24 milliard d’euros, en hausse de 3,8 %.
La fraude par manipulation pèse 516 millions d’euros, en hausse de 34 % en un an. C’est 41,6 % de toute la fraude, contre 32,1 % en 2024. Sa part a doublé en quatre ans.
La fraude à la carte recule : 475 millions d’euros, en baisse de 8,6 %, avec un taux de fraude au plus bas historique.
Le virement devient le moyen de paiement le plus fraudé : 39 % de la fraude, contre 30 % en 2024.
La « manipulation », c’est quand la victime valide elle-même l’opération parce qu’on l’a convaincue : le faux conseiller bancaire (« une opération suspecte sur votre compte, validez ceci pour la bloquer »), le faux service anti-fraude, la fraude au président, le faux fournisseur qui change d’IBAN. Une précision sur ce que j’ai dit à l’antenne : les 516 millions couvrent toute la fraude par manipulation, pas seulement les faux conseillers.
Autre précision, importante : ces chiffres ne parlent pas de voix clonées. Il n’existe aucune statistique officielle sur la fraude par clonage vocal en France, et aucun cas avéré n’a été rendu public à ma connaissance. Mais le mécanisme est celui de l’appel de la démo : la carte est de mieux en mieux protégée, alors les escrocs contournent la technique et s’adressent à la personne. Une voix de synthèse rend le faux conseiller ou le faux proche encore plus crédible. Et côté entreprises, le baromètre France Num ajoute que 39 % des TPE et PME ont subi au moins un incident de cybersécurité en douze mois.
🎧 Pour creuser le sujet
👉 Écouter l’épisode #136 : https://shows.acast.com/tsunam-ia/episodes/136-cette-voix-nexiste-pas
🔗 Le deck de l’épisode, avec la démo « Cette voix n’existe pas » à réécouter : https://live.tsunamia.fr/136
🏁 Promis à l’antenne : la course Wikipédia de Jev, à rejouer sur le deck du #135 : https://live.tsunamia.fr/135
Au Boulot, la plateforme d’agents IA autonomes : https://boulot.ai
🎁 30 jours offerts sur Au Boulot avec le code TSUNAMIA : https://boulot.ai/?code=TSUNAMIA
Pour conclure
Une question tenait tout l’épisode : qui est vraiment au bout du fil ? Une voix qui n’existe pas, un agent qui n’accepte pas un non, une promesse qui n’engage à rien. À chaque fois, la parade est simple et humaine : ralentir quand on vous presse, vérifier par un autre canal, écrire les règles avant d’en avoir besoin. Ce soir, choisissez votre mot de passe familial. Et d’ici le prochain épisode, surveillez vos agents.
Dimitri
📬 Restons connectés - 🌐 Site : tsunamia.fr - 🎧 Le podcast sur Acast (et toutes les plateformes) - 📸 Instagram et TikTok - ✉️ Me contacter : contact@tsunamia.fr
TsunamIA est une marque propulsée par Intégralité Consulting.