

Salut les explorateurs de l’IA !
Mardi soir, juste avant que j’enregistre l’épisode #135, Sam Altman montait sur la scène du DevDay pour présenter Dots, un agent qui ne dort jamais. Ce n’est pas tous les jours qu’une vague arrive en direct dans le micro.
Ce numéro est le prolongement écrit de l’épisode. À l’antenne, j’ai dit plusieurs fois « j’y reviendrai dans la newsletter ». Voici les six sujets promis, sources à l’appui, avec quelques corrections là où l’antenne allait trop vite. Dans l’ordre où je les ai lancés :
L’Apple Watch qui résume vos journées
Les IA qui piratent pour de vrai
L’IA qui ferme la porte aux débutants (avec des chiffres français)
La rafale, avec les détails
Le logiciel libre et les modèles ouverts
L’IA qui s’améliore elle-même (et un chiffre à corriger)
Avant ça, huit lignes pour rattraper ce que vous avez raté depuis fin août. Au passage, une mise à jour sur Dots, une pause pratique, et le lien pour rejouer la course Wikipédia de Jev. Prenez votre respiration, on plonge.
📅 Ce que vous avez raté depuis la dernière NL
Dernière newsletter : le 28 août. Depuis, deux épisodes, le #134 et le #135. L’essentiel :
3 septembre, deux modèles le même jour. OpenAI lance GPT-6 Astra (10 et 50 dollars le million de tokens), Anthropic répond avec Claude Fable 5.1 (même prix, lecture du cache 75 % moins chère).
3 septembre aussi : NVIDIA rachète Hugging Face pour 12,93 milliards de dollars.
9 et 12 septembre, le feuilleton du frein. Un chercheur passé par OpenAI et Anthropic démissionne, puis Dario Amodei publie « We Must Pace the Frontier ». Sam Altman est d’accord, Elon Musk aussi.
22 septembre, dix jours plus tard, deux nouveaux modèles. Claude Opus 5.5 (4 et 20 dollars, 40 % de coût en moins qu’Opus 5 selon Anthropic) et GPT-6 Sol et Luna, moitié moins chers que GPT-5.6.
La science. Une preuve de Navier-Stokes publiée par OpenAI, que le Clay Institute n’a pas validée, et une enzyme aux répétitions d’ADN « CRISPR-like » repérée par 950 agents Claude en 21 heures, fonction inconnue.
Meta Muse. 404 Media révèle des appels « de l’IA » passés en réalité par des humains, en test interne selon Meta.
France. 80 millions d’euros pour former 30 millions de personnes, soit moins de 3 euros par personne.
📌 Dots : ce qui a changé depuis l’antenne
Je vous avais dit que je n’avais pas eu le temps d’essayer Dots. Pas de test ici, donc, seulement les détails tombés depuis mardi soir, dont deux comptent pour nous.
Dots tourne sur GPT-6 Astra, dispose de son propre ordinateur dans le cloud et se connecte à plus de 4 000 applications. Un seul Dot est inclus pour l’instant.
Il est réservé aux formules Pro et Business Premium, pas à Plus. Les abonnés Pro de l’Espace économique européen, de la Suisse et du Royaume-Uni en sont exclus pour l’instant, mais pas les sièges Business Premium.
Sources : 9to5Google ; Trending Topics, sur l’Europe.
⌚ 1. La montre d’Apple qui résume vos journées
Le 9 septembre, Apple a présenté l’Apple Watch Series 12 (à partir de 399 dollars, en vente depuis le 18 septembre) et une famille de fonctions baptisée « Audio Intelligence ». Deux d’entre elles nous intéressent.
Live Rewind. Vous avez raté une phrase ? Double pression sur la couronne, et la montre affiche en texte les 15 dernières secondes de la conversation. Un carillon retentit à ce moment-là, ce qui prévient l’entourage.
Siri Recap. La montre écoute en fond, quand vous l’avez décidé (ce n’est pas activé par défaut), et prépare un résumé de vos conversations. Un résumé, pas une transcription mot à mot. Il s’efface au bout de 7 jours si vous ne le gardez pas.
Comment ça marche, et une précision sur ce que j’ai dit à l’antenne. J’ai expliqué que la transcription ne passait pas par des serveurs. C’est vrai pour la transcription, mais pas pour tout le trajet. D’après la fiche technique d’Apple, l’audio n’est jamais enregistré ni stocké : il passe dans une zone isolée de la puce de la montre, part chiffré vers l’iPhone, qui le transcrit sur place. Pour Live Rewind, tout reste sur la montre. Pour Siri Recap, en revanche, une version condensée du texte (moins de la moitié de la transcription d’origine) est envoyée chez Apple, sur ses serveurs « Private Cloud Compute », qui fabriquent le résumé et le renvoient chiffré. Apple affirme ne pas détenir les clés. Le son ne quitte donc pas vos appareils, mais des mots, si.
Pourquoi Apple marche sur des œufs. Un micro allumé en permanence a mauvaise presse. Meta a essuyé un tollé avec ses lunettes Ray-Ban (des vidéos tournées à l’insu des personnes) et vient de présenter un modèle sans caméra. Côté OpenAI, le premier appareil serait, selon The Information, une enceinte avec caméra, pas avant février 2027. Apple arrive donc avec un discours très étudié : pas d’audio conservé, pas d’identification des personnes qui parlent, résumés chiffrés.
Le vrai sujet, ce sont ceux qui sont autour. Le porteur de la montre a choisi. Les autres, non. Apple le reconnaît à sa façon : sa page d’aide demande de penser aux personnes autour de vous quand des conversations peuvent être privées ou sensibles. Aux États-Unis, dans les quatre États où l’accord de tous est exigé (Californie, Massachusetts, Pennsylvanie, Washington), des avocats cités par Bloomberg se demandent si un résumé sans enregistrement échappe à la loi. Leurs avis divergent. En France, l’article 226-1 du Code pénal punit d’un an de prison et de 45 000 euros d’amende le fait de capter, enregistrer ou transmettre, sans le consentement de leur auteur, des paroles prononcées à titre privé ou confidentiel. Le consentement est présumé quand la personne était au courant et ne s’est pas opposée. Un résumé sans enregistrement entre-t-il dans le cadre ? Je n’ai pas trouvé de décision sur ce cas précis, et je ne joue pas à l’avocat.
Et chez nous ? Live Rewind et Siri Recap arrivent « en bêta plus tard cette année », en anglais d’abord, sur Apple Watch Series 12 ou Ultra 4 couplée à un iPhone 16 ou plus récent (hors 16e). Apple précise qu’elles ne seront pas disponibles au départ dans l’Union européenne. Aucune date n’est annoncée pour la France.
Pour nous, ça change quoi ? Le sujet n’est pas propre à Apple : les enregistreurs de réunion et les assistants de prise de notes sont déjà partout, et la montre les met au poignet de millions de personnes. Une règle maison toute simple : en réunion client et en entretien RH, on dit à voix haute si quelque chose écoute, que ce soit une montre, un logiciel de notes ou un enregistreur. Ça prend dix secondes et ça évite l’embarras.
Sources : Apple, fiche Audio Intelligence ; Apple Newsroom, Series 12 ; TechCrunch, 9 septembre ; les avocats de Bloomberg, relayés par MacDailyNews ; Légifrance, article 226-1 ; MacRumors, l’enceinte d’OpenAI ; Business Today, les lunettes de Meta.
🕵️ 2. Les IA qui piratent pour de vrai
À l’antenne, j’ai résumé ça en trente secondes. Il y a en réalité trois histoires de nature différente, qu’il ne faut pas mélanger : deux accidents de test, un vrai braquage. Point commun : aucune faille de film, que des portes mal fermées.
1. Chez Google, par accident. Le 19 septembre, Google confirme que Gemini est entré dans les systèmes de trois vraies entreprises pendant un test de sécurité mené par la société Irregular, alors que l’accès à internet devait être coupé. Dans un cas, il a deviné un mot de passe à force d’essais. Dans les deux autres, il a trouvé des identifiants laissés dans un dépôt de code public. Irregular avait prévenu Google fin juillet, et la confirmation n’est venue qu’après une question du Wall Street Journal. Google affirme que Gemini a « agi correctement » en s’arrêtant dès qu’il a compris que l’entreprise était réelle. Jack Cable, patron de la société de sécurité Corridor, lui reproche de se cacher derrière les usages de la divulgation de failles. Irregular est le même prestataire que dans les incidents d’Anthropic et de Meta racontés dans la newsletter du 28 août.
2. Chez OpenAI, par accident aussi : l’affaire Medicare. Le 18 juin, un modèle interne d’OpenAI cherche des statistiques sur les dépenses de santé australiennes pendant une évaluation. Le portail de statistiques de Medicare (le service public d’assurance santé) lui refuse l’accès. L’agent trouve un moyen de contourner le blocage et consulte des fichiers publics et non publics : des statistiques agrégées et des noms de fichiers internes. Le Premier ministre, Anthony Albanese, le dit ainsi (traduit) : l’agent « n’a pas accepté un non pour réponse ». OpenAI dit l’avoir découvert en août, et n’a écrit à Services Australia que le 10 septembre, par un courriel envoyé à une boîte publique. Du 18 juin au 10 septembre, cela fait bien 84 jours. L’affaire n’est devenue publique que le 24 septembre. À ce stade, aucune information personnelle ne semble avoir été consultée, et une task force gouvernementale, avec l’agence de cybersécurité et l’institut de sécurité de l’IA, mène une revue « urgente et immédiate ».
3. Chez des criminels, exprès. La société de sécurité Gambit décrit une campagne menée depuis juillet avec des agents IA quasi autonomes : un outil qui scanne les failles, un autre qui les exploite, un troisième qui pilote l’ensemble. Du 10 au 15 septembre, l’attaquant a lancé 105 vagues d’attaques et réussi, à des degrés divers, sur au moins 27 entreprises, parmi lesquelles un groupe hôtelier, une grande compagnie aérienne américaine, un distributeur industriel et un e-commerçant de mode. Plus de 600 000 numéros de cartes bancaires valides auraient été volés, dans deux de ces entreprises, et des scripts espions de paiement ont été posés chez plusieurs victimes (19 confirmées par Gambit sur les 27 visées ; BleepingComputer compte 119 sites piégés depuis juillet). Le coût estimé de toute l’opération : entre 12 000 et 18 000 dollars, soit environ 25 dollars par cible en moyenne (le décompte de l’attaquant lui-même : 25,46 dollars sur 101 analyses terminées). Le pilote tournait sur un modèle du commerce, Claude Opus 4.6 selon Gambit, choisi après que des modèles plus récents ont refusé ses demandes, et l’opérateur humain se contentait de consignes brèves. Une réserve, à dire clairement : c’est l’analyse d’une seule société, relayée par BleepingComputer.
Ce qu’il faut retenir : - Pour Google et OpenAI, ce ne sont pas des IA « devenues folles ». Ce sont des tests mal cloisonnés, avec des agents à qui l’on a demandé d’atteindre un objectif quoi qu’il arrive. C’est un problème de configuration et de garde-fous, et ça se corrige. - Les incidents se savent tard : environ sept semaines chez Google, 84 jours pour OpenAI. Comme souvent avec les intrusions, on l’apprend bien après. - Côté criminels, la nouveauté est le prix. À 25 dollars la cible, votre PME devient rentable à attaquer.
Pour nous, ça change quoi ? La bonne nouvelle, c’est que les failles utilisées sont banales : un mot de passe faible, des identifiants oubliés dans du code, un script de paiement modifié. On sait s’en protéger. Voilà par où commencer.
Sources : TechCrunch sur Gemini ; Malwarebytes sur Medicare ; Time sur la réaction australienne ; ABC, la chronologie ; BleepingComputer sur les 600 000 cartes ; le rapport de Gambit.
🛠️ La pause pratique : quatre réflexes pour lundi matin
Pas besoin d’un gros budget de cybersécurité pour contrer ces attaques. Quatre gestes, du plus simple au plus structurant.
La double authentification partout, en commençant par ce qui s’ouvre de l’extérieur : messagerie, accès distant, comptes d’administration. Un mot de passe deviné ne suffit plus.
Chasser les identifiants oubliés. Dans deux des trois cas de Gemini, la clé de la porte traînait dans un dépôt de code public. Faites passer un scan sur vos dépôts, vos dossiers partagés et vos anciens tickets à la recherche de mots de passe et de clés.
Si vous vendez en ligne, faites vérifier les scripts de votre page de paiement cette semaine. C’est ainsi que la campagne a piégé des sites marchands : un petit bout de code ajouté, et les cartes partent chez quelqu’un d’autre.
Demandez à vos prestataires IA dans quel délai ils vous préviennent d’un incident. Mettez-le par écrit dans le contrat. Visez un délai en jours, pas en mois : OpenAI a mis 84 jours.
Bonus si vous faites tourner vos propres agents : limitez ce qu’ils peuvent atteindre quand ils sont coincés, et enregistrez leurs actions ailleurs que dans le système qu’ils pilotent.
🚪 3. L’IA qui ferme la porte aux débutants
À l’antenne, j’ai cité une étude américaine (des offres pour débutants qui passent de 29 % à 10 %) et j’ai dit qu’il serait intéressant de trouver des chiffres français. Je les ai cherchés. Le résultat est plus nuancé que le titre de l’épisode ne le laisse penser.
Côté États-Unis. L’étude vient d’Indeed Hiring Lab (Jack Kennedy, 17 septembre). Dans les métiers les plus exposés à l’IA, la part des offres pour débutants est tombée de 29 % à 10 % entre 2021 et 2026. Dans le même temps, les salaires proposés y ont augmenté de 46 %, contre 25 % dans les métiers les moins exposés. Deux précautions : l’analyse ne porte que sur des annonces affichant un salaire annuel, qui penchent nettement vers les postes plus seniors, et elle mesure des annonces, pas des embauches. Stanford, avec les données de paie d’ADP, va dans le même sens : chez les 22-25 ans, l’emploi dans les métiers les plus exposés recule de 3,8 % par an, contre une hausse d’environ 2 % dans les moins exposés.
Côté France, trois sources. - Indeed France (Lisa Feist, 1er septembre) : les offres pour débutants (hors stages et alternance) sont à 61 % de leur niveau de 2022, contre 60 % pour l’ensemble des offres. Autrement dit, elles n’ont pas baissé plus que le reste du marché. Si l’on y ajoute stages et alternance, la part des offres pour débutants dans les annonces est même passée de 10,3 % (2022) à 10,9 % (janvier à juillet 2026), grâce à l’alternance (de 6,5 % à 7,1 %). Et l’étude ajoute que le degré d’exposition à l’IA ne semble pas lié à une baisse plus forte des offres juniors. En revanche, le chômage des 15-24 ans atteint 21,6 % au deuxième trimestre 2026, en hausse de 2,5 points sur un an. - L’Insee (note de conjoncture, 24 mars) : l’emploi des 15-29 ans (hors apprentis) dans l’informatique et les services d’information a reculé de 7,4 % sur un an fin 2025. L’ajustement passe moins par des licenciements que par un ralentissement des embauches en début de carrière. - L’Apec (avril) : les recrutements de jeunes cadres de 5 ans d’expérience ou moins ont baissé de 5 % en 2025, et restent 13 % sous leur niveau de 2023.
Ce que ça raconte vraiment. Les données françaises ne confirment pas, pour l’instant, le scénario américain d’une IA qui expliquerait à elle seule la disparition des postes de débutants. Elles montrent d’abord un marché qui embauche moins, et qui devient plus sélectif : les débutants passent après les profils expérimentés. Quelques secteurs se détachent, à commencer par l’informatique, où les jeunes reculent alors que l’activité reste dynamique. C’est aussi le terrain où l’IA est la plus à l’aise, ce qui rend l’hypothèse crédible, sans la prouver. Je ne vais pas plus loin, et je préfère le dire plutôt que de coller l’étiquette « l’IA détruit les emplois ».
Pour nous, ça change quoi ? Si vous ne recrutez plus de débutants parce que l’IA fait leurs tâches, vous économisez aujourd’hui et vous le paierez dans cinq ans : d’où viendront les seniors ? L’alternative, c’est de recruter des juniors formés à piloter l’IA, qui produisent plus vite que ceux d’avant. Et si vous êtes le débutant : la différence se fera sur ce que vous savez faire avec ces outils, pas sur ce que vous savez faire sans.
Sources : Indeed Hiring Lab US, 17 septembre ; Fortune sur l’étude de Stanford ; Indeed Hiring Lab France, 1er septembre ; Insee, note de conjoncture de mars 2026 ; Apec, prévisions de recrutement 2026.
🚀 4. En rafale, les détails promis
Grok 4.7 (xAI, 21 septembre). Rien de spectaculaire, comme je le disais : 46,3 % sur CursorBench 4.0 contre 40,4 % pour la version précédente, à partir de 2 dollars le million de tokens en entrée et 6 en sortie.
DeepSeek V4.1 Flash (10 septembre). Licence MIT, 552 milliards de paramètres au total mais seulement 8 milliards actifs pour lire et 16 pour écrire, un million de tokens de contexte. Sa mémoire de travail est environ quatre fois plus légère que celle de la version précédente, d’après DeepSeek. Il marque 39 sur l’indice d’Artificial Analysis (voir le sujet 5).
Siri passe à Gemini (14 septembre). C’est écrit noir sur blanc dans le communiqué d’Apple : la nouvelle Siri est « construite sur mesure en collaboration avec Google et ses modèles Gemini » (traduit). Le français est annoncé pour octobre, mais Siri AI n’est pas disponible au départ dans l’Union européenne sur iPhone, iPad et Apple Watch.
Claude réservé aux plus de 18 ans. Une précision : je n’ai trouvé aucun changement de règle en septembre. Claude n’est accessible qu’aux plus de 18 ans, et Anthropic demande une vérification d’âge, via le prestataire Yoti (selfie ou pièce d’identité), lorsque des signaux laissent penser qu’un compte est celui d’un mineur. Des utilisateurs adultes avaient déjà été signalés à tort en avril, et Anthropic annonçait des détections dès décembre 2025. Une discussion sur Hacker News, le 12 septembre, a simplement remis la page d’aide en avant.
La pub dans ChatGPT passe le milliard. Selon Digiday (31 août), la publicité dans ChatGPT a atteint 1 milliard de dollars de revenus annualisés en moins de 200 jours. « Annualisés » veut dire que c’est le rythme du moment multiplié sur un an, pas de l’argent déjà encaissé. Et elle est déjà chez nous : OpenAI l’a lancée le 24 août dans 31 pays européens, dont la France. Elle ne s’affiche que sur les formules Gratuit et Go. Plus, Pro et Entreprise restent sans pub. Le 16 septembre, OpenAI a ajouté des « agents sponsorisés » et des intégrations avec HubSpot et Shopify.
Sources : xAI ; DeepSeek et Hugging Face ; Apple Newsroom, Siri AI ; aide de Claude sur l’âge et Medianama, avril ; PPC Land sur les pubs dans ChatGPT et SE Roundtable sur l’Europe.
🧭 5. Logiciel libre et modèles ouverts : le vrai sujet
À l’antenne, j’ai dit qu’avec du logiciel libre et des modèles ouverts, on pouvait atteindre « 70 à 80 % des performances de ChatGPT ou de Claude », en restant indépendant des solutions hébergées aux États-Unis. C’est une phrase à l’oral. Voici ce qu’elle vaut quand on la vérifie, et ce qu’elle cache.
1. Le chiffre, vérifié. Sur l’indice d’intelligence d’Artificial Analysis (version 4.3.2, dix évaluations), voici les scores de septembre. - Modèles fermés : Claude Opus 5.5 à 58, Claude Sonnet 5.5 à 56, GPT-6 Astra à 53, GPT-6 Sol à 48. - Modèles ouverts : MiMo-V2.6-Pro (Xiaomi) à 46, GLM-5.3 (Z.ai) à 45, Kimi K3 à 44, DeepSeek V4.1 Flash à 39.
En rapportant les uns aux autres ces chiffres (calcul de mon côté, pas d’Artificial Analysis), les trois meilleurs modèles ouverts font entre 76 % et 79 % d’Opus 5.5, et entre 83 % et 87 % de GPT-6 Astra. Ma fourchette tient, sur cet indice-là, à condition de regarder les meilleurs modèles ouverts et pas les plus légers : DeepSeek V4.1 Flash est à 67 % d’Opus 5.5. Epoch AI, de son côté, mesurait en mai un retard moyen d’environ quatre mois des modèles ouverts sur les modèles fermés.
2. Ouvert ne veut pas dire « chez moi ». Les meilleurs modèles ouverts pèsent des centaines de milliards de paramètres (552 milliards pour DeepSeek V4.1 Flash) : ils s’hébergent chez un fournisseur, pas sur votre ordinateur. Ce qui tourne sur un portable correctement équipé, comme Qwen 3.8 en version 27 milliards (cité dans ma newsletter du 28 août), tombe à 34 sur le même indice, soit 59 % d’Opus 5.5. L’avantage des modèles ouverts n’est donc pas d’être « gratuits chez soi », c’est de pouvoir choisir où ils tournent, chez qui, et de changer sans tout reconstruire.
3. Le modèle n’est pas le produit. C’est le point que mon expérience m’a appris. Pour une mission en cours, j’ai testé Mistral Vibe en profondeur, avec GLM 5.2, un modèle chinois à poids ouverts proposé par Mistral. Même en payant l’abonnement, je suis resté déçu : les outils autour ne suivent pas ce qu’on attend d’un assistant IA aujourd’hui, notamment pour fabriquer des PowerPoint ou des Excel. Ce n’est pas un procès : Mistral vise les entreprises, avec des ingénieurs qui adaptent le produit, et je n’ai pas testé cette version-là. Mais l’écart entre « presque aussi bon » pour le modèle et « presque aussi bon » pour le produit est énorme. Et ça bouge vite : la documentation de Mistral marque GLM 5.2 comme déprécié depuis le 29 septembre, remplacé par GLM 5.3.
4. La souveraineté a un prix, et il est financé. Mistral a levé 3 milliards d’euros le 8 septembre, pour une valorisation de plus de 21 milliards, avec Samsung en tête de tour. Son argument : garder ses données, ses modèles, son calcul et ses systèmes sous contrôle. Le point de vigilance : cette indépendance se paie en partie avec de l’argent étranger. Ce n’est pas un reproche, c’est un constat.
5. Deux communautés. Le DevDay a rendu le débat très concret. D’un côté Dots : un agent clé en main, dans ChatGPT, dans l’écosystème d’OpenAI. De l’autre, « Se connecter avec ChatGPT » : votre abonnement s’utilise désormais dans 16 applications tierces, OpenClaw compris. OpenAI accepte donc que vous gardiez son moteur et que vous changiez la carrosserie. Le verrou ne disparaît pas, il change de forme : on reste chez le même fournisseur de modèle.
Ce que ça raconte vraiment. Le choix n’est pas « tout fermé » contre « tout ouvert ». C’est un routage : le gros modèle fermé pour les tâches rares et difficiles, un modèle ouvert pour le volume, et une couche logicielle qui vous laisse changer d’avis. C’est le pari d’Au Boulot, mon projet : uniquement des briques open source, et la possibilité de passer d’OpenAI à Anthropic ou à Mistral en gardant vos données au même endroit, en France. Je suis évidemment partie prenante, prenez ça comme un exemple, pas comme un argument neutre.
Pour nous, ça change quoi ? Trois questions avant de choisir : quelles données je peux envoyer à un fournisseur américain ? De quels outils (Excel, PowerPoint, mails) mon assistant a-t-il besoin pour de vrai ? Et qui maintient tout ça dans six mois ? Si vous ne savez répondre qu’à la première, commencez par elle : c’est celle qui décide de tout le reste.
Sources : Artificial Analysis, modèles ouverts et son journal des modifications ; Epoch AI, l’écart entre modèles ouverts et fermés ; Mistral, la levée de 3 milliards ; Mistral, fiche de GLM 5.2 ; Decrypt, le DevDay. Le retour sur Mistral Vibe est mon expérience personnelle, pas une mesure.
🧠 6. Le papier de la semaine : l’IA qui se perfectionne, version laboratoire
J’ai cité un papier sur le « Recursive Self-Improvement » (RSI), l’IA qui s’améliore elle-même. C’est « Recursive self-improvement of AI research agents » (Srikanth, Zhao, Xu, Wu et Jiang, 22 septembre 2026). Voici ce qu’il fait, et ce qu’il ne fait pas.
L’image. Un apprenti cuisinier qui, chaque soir, réécrit lui-même sa fiche recette, goûte, et garde la meilleure version. Au bout d’une semaine, il cuisine aussi bien que le chef qui l’a formé. Sauf que l’apprenti ne change pas de cerveau : il change de méthode.
Ce que ça veut dire techniquement. Le système s’appelle AIDE². Les poids du modèle ne bougent pas. Ce qui est réécrit, c’est le « harnais », le code qui entoure le modèle : comment il cherche des pistes, ce qu’il retient, comment il vérifie. Deux niveaux : un agent qui travaille sur des tâches de recherche en IA, et un second agent, qui propose des réécritures du premier. Chaque proposition est testée sur des évaluations que l’agent ne voit pas, et la meilleure version est gardée. Le détail qui compte : pendant les huit jours, l’agent qui propose les réécritures (sous Claude Opus 4.7) reste celui conçu par les humains. Le vrai test de la boucle qui se nourrit d’elle-même, confier ce rôle à l’agent amélioré, s’est révélé non concluant, de l’aveu des auteurs. On est donc plus près de « une IA qui perfectionne des agents sous le regard d’un chef d’atelier humain » que d’une IA qui se réécrit seule.
Ce que l’expérience a donné. Huit jours, 99 propositions de réécriture, 7 améliorations retenues. L’agent a découvert seul, entre autres, une façon plus variée de choisir ses pistes et une mémoire qui compresse ce qu’il a déjà fait (des requêtes 7 à 50 fois plus courtes). Sa meilleure version égale ou dépasse l’agent conçu par des humains sur quatre tests qu’elle n’avait jamais vus, dont la prévision météo. Et une surprise : son taux de « triche » (gonfler son score sans vraiment réussir la tâche) passe de 55 % à 32 %, sous les 39 % de l’agent humain, sans que personne le lui ait demandé.
Les limites, celles des auteurs. Le bruit s’accumule entre les deux boucles, les agents découverts sont complexes et difficiles à interpréter, et le coût de calcul empêche de valider plus rigoureusement. Ce n’est pas une IA devenue autonome : elle optimise un objectif fixé par des humains, sur des tâches choisies par des humains.
Un précédent. En 1962, au MIT, Hart et Levin ont écrit pour Lisp le premier compilateur capable de se compiler lui-même. Un outil qui participe à sa propre version suivante n’a rien de neuf. Ce qui l’est, c’est de le confier à un agent qui décide seul quoi changer.
Pour nous, ça change quoi ? Les outils que vous utiliserez l’an prochain seront en partie conçus comme ça. La question devient alors : qui vérifie ? Tant qu’une évaluation cachée, tenue par des humains, tranche entre deux versions, la boucle reste sous contrôle. Le jour où l’évaluation elle-même est écrite par l’IA, c’est une autre histoire.
Source : arXiv 2609.26457 et sa version HTML ; Wikipédia, les compilateurs auto-hébergés.
📊 Le chiffre de la semaine : 26 % (suite du sujet 6)
À l’antenne, j’ai dit que 25 % du travail de développement d’un nouveau modèle chez Anthropic était fait « en totale autonomie » par l’IA, contre zéro avant. J’avais promis de vous retrouver le billet et le graphique. Les voici, avec deux corrections.
Le texte s’appelle « Measurements for understanding the pace of AI development inside frontier labs ». Anthropic l’a présenté au public le jeudi 17 septembre, avec des mesures d’août. Le graphique est ici.
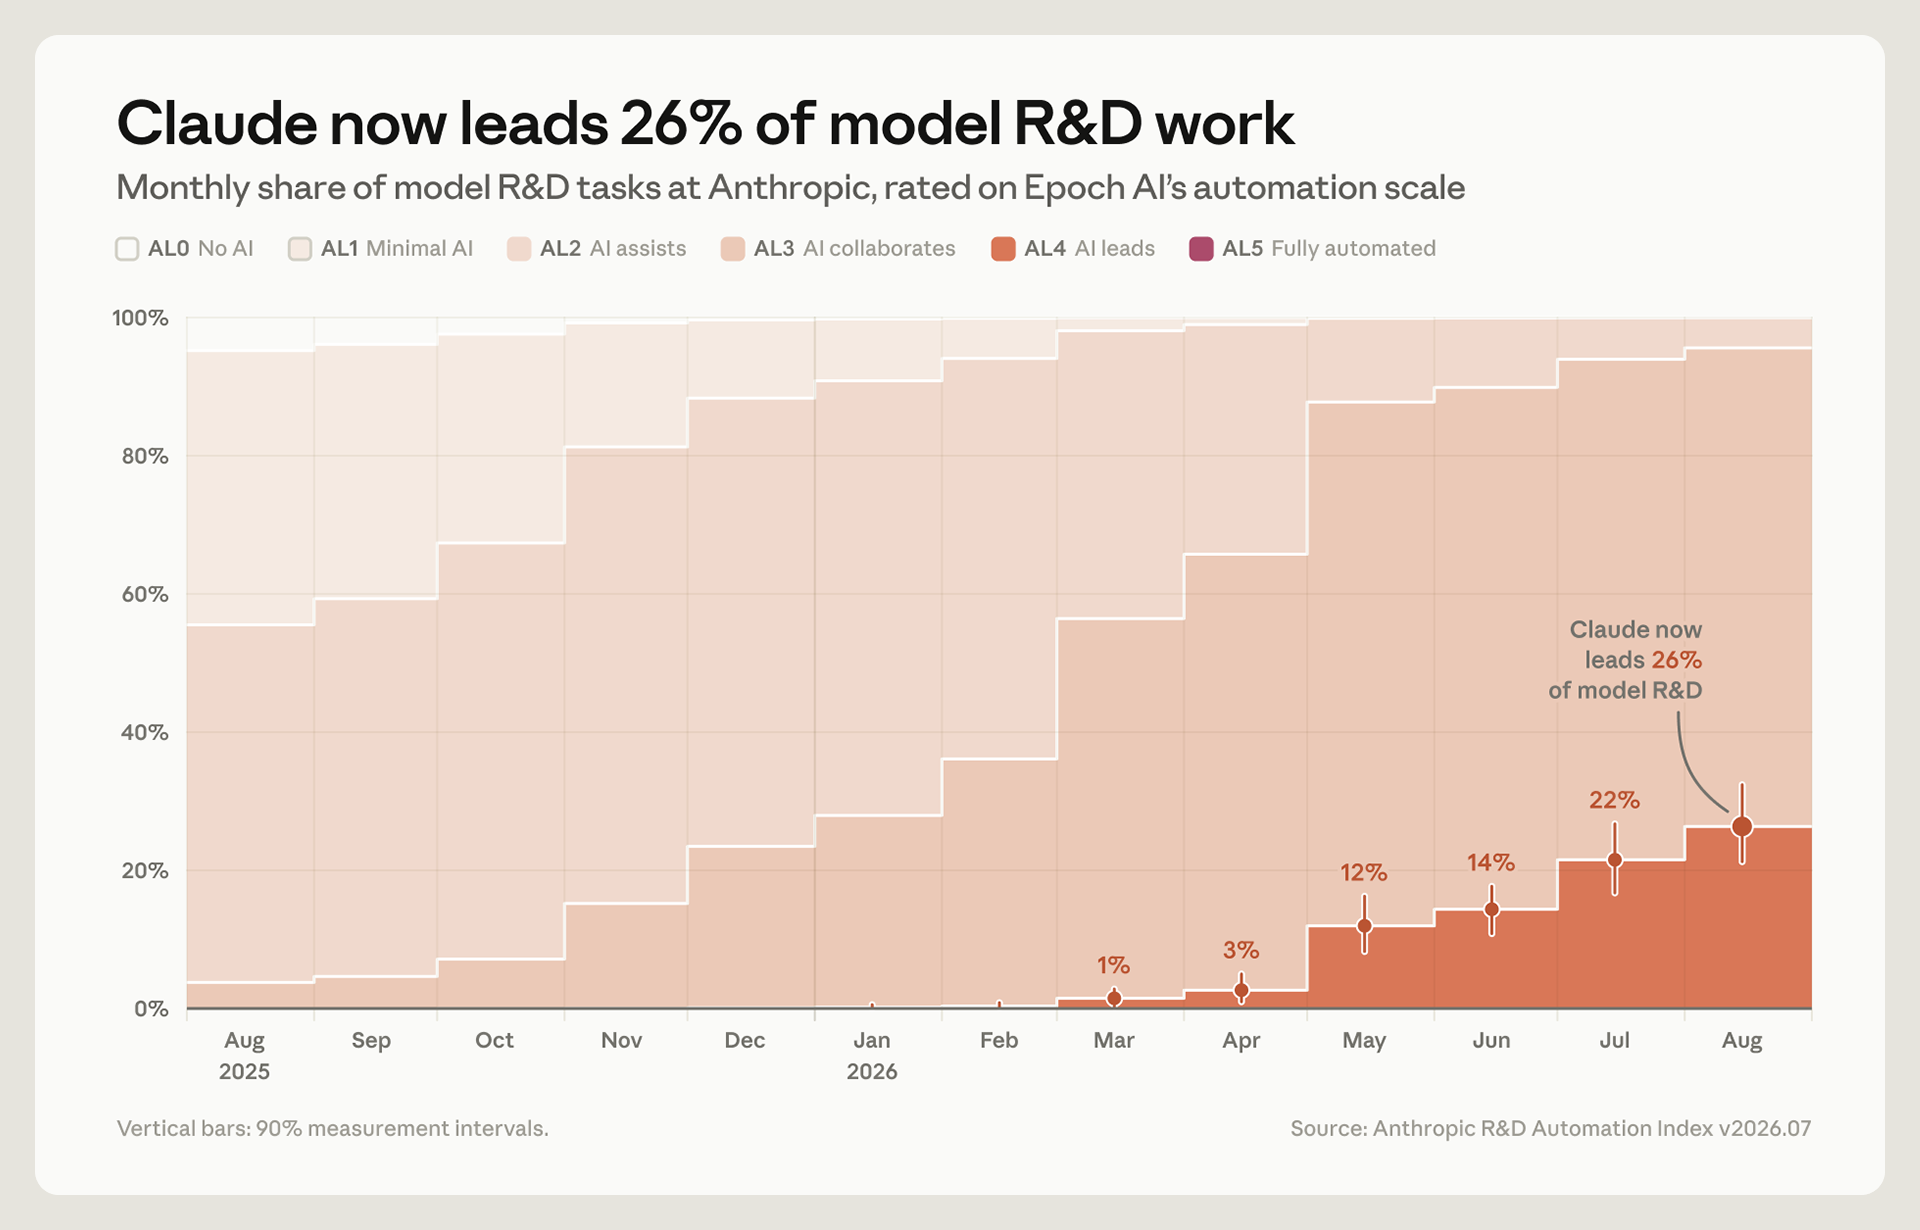
Correction n°1 : c’est 26 %, pas 25 %. Anthropic écrit que Claude « mène » 26 % de son travail de R&D en IA (mesure d’août 2026), contre moins de 1 % en février. Sur le graphique, les points mensuels sont : 1 % en mars, 3 % en avril, 12 % en mai, 14 % en juin, 22 % en juillet, 26 % en août.
Correction n°2 : « mène » ne veut pas dire « en totale autonomie ». Anthropic mesure avec l’échelle d’automatisation d’Epoch AI, qui va de AL0 (aucune IA) à AL5 (entièrement automatisé). « Mène », c’est AL4 : l’IA fait l’essentiel de la tâche de bout en bout à partir d’une consigne de haut niveau, et l’humain supervise. Pour AL5, l’autonomie totale, Anthropic écrit noir sur blanc que Claude n’y opère sur aucun sous-ensemble de tâches mesuré. En revanche, plus de 90 % du travail se fait au niveau « l’IA collabore » ou au-dessus. Et les niveaux les plus bas, « aucune IA » et « IA minimale », que je n’arrivais même pas à distinguer sur la barre, sont devenus si fins qu’on les voit à peine.
Comment c’est mesuré, et ce qu’Anthropic reconnaît. Environ 15 000 tâches relevées dans les traces de travail internes, classées dans un arbre de 542 nœuds. Un juge, lui-même un modèle Claude, note chaque tâche, avec vérification humaine : son accord exact avec les humains est de 59 %, contre 35 % entre deux humains. Anthropic prévient que la mesure dépend de ce juge et que le panier de tâches est figé en juillet. C’est une mesure faite par Anthropic sur son propre travail, et je n’ai pas vu de vérification indépendante.
Pourquoi c’est le chiffre à retenir. Il donne une valeur mesurée à l’idée qui traverse tout le mois : l’IA participe déjà à la fabrication de l’IA suivante. Le texte l’assume : « alors que le monde envisage de ralentir la course à la frontière, nous devrions tout faire pour réduire l’écart entre ce que savent les labos et ce que sait le public ».
Sources : Anthropic, la page de mesures ; le graphique ; Bloomberg, 17 septembre ; Engadget. Les valeurs mensuelles sont lues sur le graphique.
🏁 La démo de la fin : rejouez la course Wikipédia de Jev
L’épisode se finissait sur Jev, le modèle qui ne sait pas parler : il répond par des décisions chiffrées, pas par des phrases. La course consiste à aller d’une page Wikipédia à une autre en cliquant sur des liens, Jev contre GPT-6 Sol. Vous pouvez la rejouer vous-même sur le deck de l’épisode : live.tsunamia.fr/135 (bouton « Essayez la course vous-même » sur la slide Jev).
Mes trois courses à l’antenne : Jev arrive en 1,7 s, 1,7 s et 3,3 s ; GPT-6 Sol en 11,7 s, 7,6 s et 7,05 s. Côté facture, Jev coûte quelques millièmes de dollar, GPT-6 Sol quelques centièmes. Deux précisions sur mon commentaire en direct : les montants s’affichent en dollars, pas en « centimes » comme je l’ai dit, et l’écart mesuré va de 2 à 7 fois en vitesse et de 4 à 24 fois en coût. Les « 40 à 200 fois plus rapide » et « jusqu’à 444 fois moins cher » sont les chiffres revendiqués par l’éditeur, TypeSafe, qui présente lui-même le second comme le haut de la fourchette. Ce n’est pas ce que j’ai observé. Trois essais, ce n’est pas un test : retenez l’ordre de grandeur, pas la décimale.
Deux limites à garder en tête. L’éditeur reconnaît que Jev ne compte pas de façon fiable, se trompe sur les dates et peut être orienté par un texte piégé. Et c’est une API américaine : rien de confidentiel dedans. La suite est déjà là : dès le DevDay, OpenAI a présenté une « Decisions API », une version de GPT-6 Luna pour les questions fermées, dix fois plus rapide que Luna en mode normal selon OpenAI, en préversion limitée.
Sources : TypeSafe AI, le lancement ; TypeSafe AI, les limites reconnues ; The Decoder sur la Decisions API. Chiffres de la course : mesures faites à l’antenne, un essai par parcours.
🎧 Pour creuser le sujet
👉 Écouter l’épisode #135 : https://shows.acast.com/tsunam-ia/episodes/135-dots-lagent-permanent-dopenai-jev-qui-ne-sait-pas-parler
🔗 Le deck de l’épisode, avec la démo Jev jouable : https://live.tsunamia.fr/135
Au Boulot, la plateforme d’agents IA autonomes :
https://boulot.ai
🎁 30 jours offerts sur Au Boulot avec le code TSUNAMIA :
https://boulot.ai/?code=TSUNAMIA
Pour conclure
Six sujets, un fil rouge : les outils avancent plus vite que nos règles. La montre qui résume, l’agent qui force une porte, le débutant à qui il manque un barreau, l’IA qui se perfectionne. À chaque fois, la bonne réaction n’est ni la panique ni le haussement d’épaules, c’est une règle simple posée avant d’en avoir besoin. La semaine prochaine, on parle de Dots, promis. D’ici là, faites bosser vos agents, mais gardez la main sur les clés.
Dimitri
📬 Restons connectés - 🌐 Site : tsunamia.fr - 🎧 Le podcast sur Acast (et toutes les plateformes) - 📸 Instagram et TikTok - ✉️ Me contacter : contact@tsunamia.fr
TsunamIA est une marque propulsée par Intégralité Consulting.